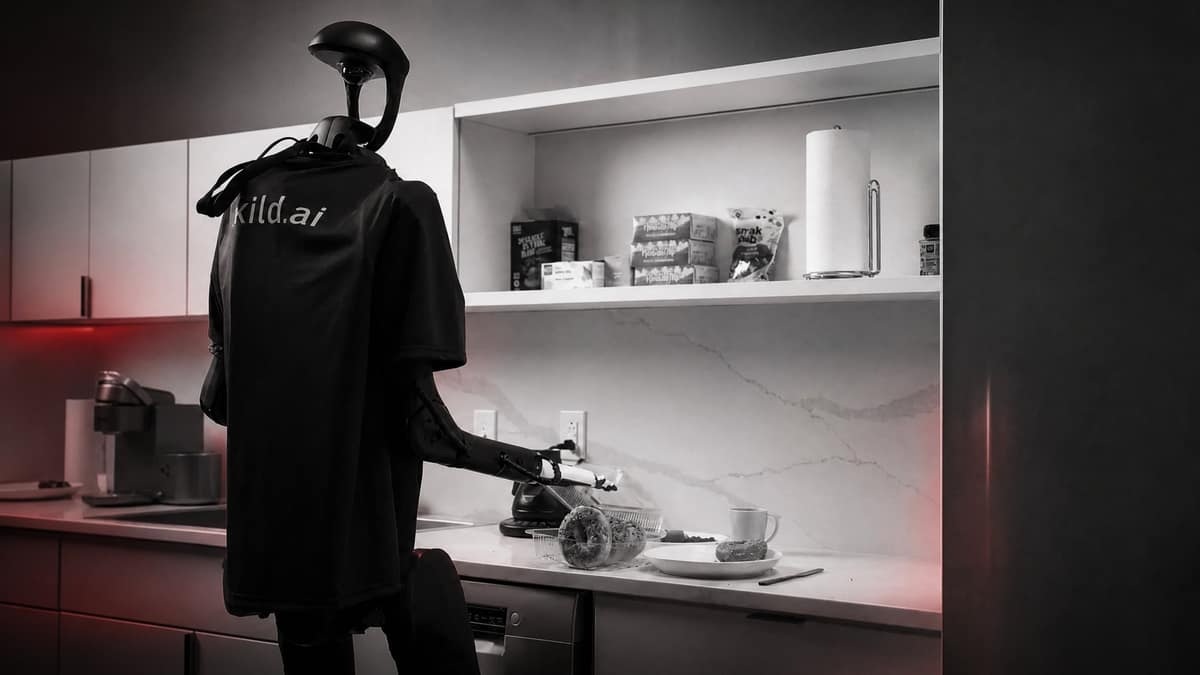
قدمت Skild AI نموذج S1، وهو نموذج الأساس الجديد للشركة في مجال الروبوتات، والقادر على تعلم مهام لم يسبق له رؤيتها من عرض توضيحي واحد عبر الفيديو، من دون ضبط دقيق.
في منشور لها يوم الثلاثاءمنشورعلى X، قالت Skild AI إن S1 يستخدم التعلم ضمن السياق لتنفيذ مهام طويلة الأفق تستمر حتى 10 دقائق. وأضافت الشركة أن S1 يستطيع تنفيذ هذه الإجراءات في بيئات متنوعة وعلى أجسام روبوتية مختلفة.
تشمل المهارات التي جرى عرضها إعداد القهوة، وزراعة نبات في أصيص، وقلي الفطائر، وهي مهارات لم تكن موجودة في بيانات التدريب المسبق للنموذج.
قالت Skild AI: «في المرة الأولى التي قلب فيها S1 فطيرة، افترضنا أن قلب الفطائر لا بد أن يكون موجودًا في بيانات التدريب المسبق. بحثنا في كامل بيانات التدريب المسبق، ولم نعثر على أي أمثلة لقلب الفطائر. استنتج S1 المهمة الخارجة عن نطاق التوزيع من مطالبة واحدة عبر الفيديو».
وبحسب الشركة، يمثل S1 «نقلة نوعية» مقارنة بنماذج الرؤية-اللغة-الفعل (VLA) التقليدية؛ إذ يستطيع مضاهاة أداء نماذج VLA التي تعتمد على المطالبات اللغوية في المهام المعروفة، كما يتفوق على نماذج VLA الحالية المعتمدة على المطالبات اللغوية في تعلم مهام جديدة تمامًا.
وقدرت Skild AI أن نماذج VLA الحالية ستحتاج إلى 50 إلى 100 ساعة من جمع البيانات الإضافية والضبط الدقيق للوصول إلى دقة مماثلة عند التعلم من مثال واحد.
كما أشار الفريق إلى أن نموذجه الجديد لا يقلد عرض الفيديو التوضيحي بشكل أعمى، بل يُظهر فهمًا «للفطرة السليمة» يتجاوز المطالبة المقدمة. ويمكنه تحمل الاضطرابات، أو الارتجال، أو حتى إظهار دقة أكبر مما ظهر في الفيديو.
يوسع S1 قدرات التعلم ضمن السياق المرتبطة بالحركة، التي كشفت عنها Skild AI في LocoFormer العام الماضي، والتي مكّنت روبوتًا من التكيف مع اضطرابات مثل تعطل الأرجل وانغلاق العجلات.
قالت Skild AI إنها بدأت نشر S1 لدى عدد محدود من الشركاء الصناعيين، وتخطط لطرح أوسع خلال الأشهر المقبلة.