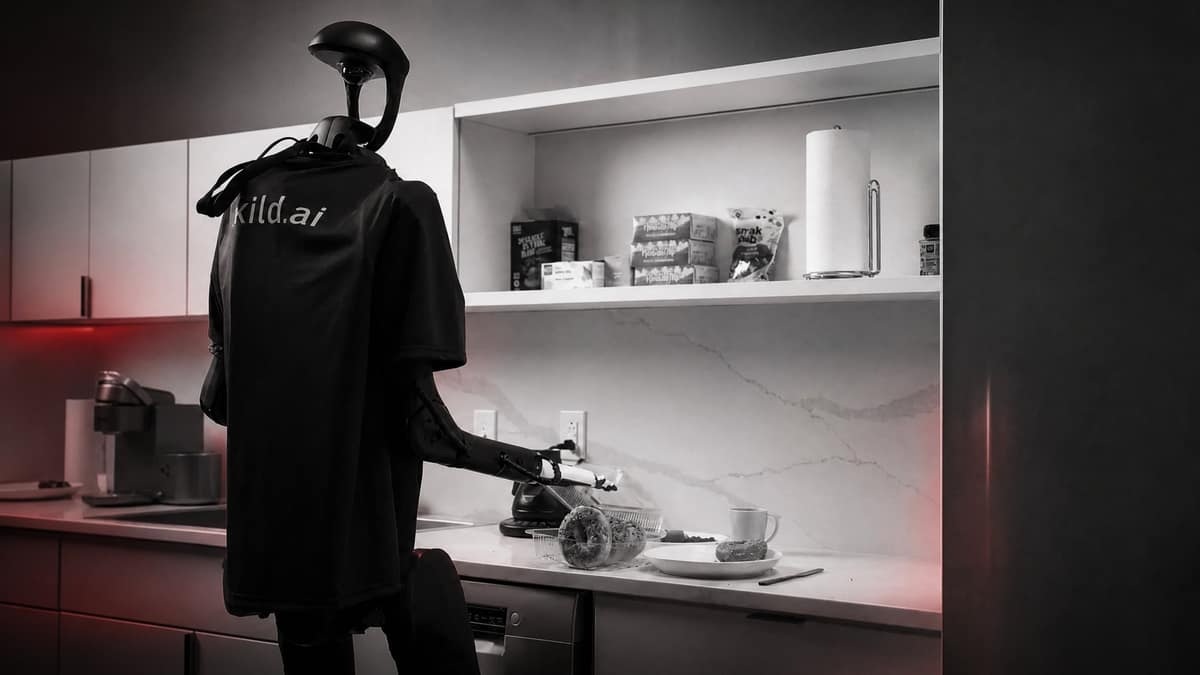
Skild AIは、1回の動画デモンストレーションからファインチューニングなしで未知のタスクを学習できる、同社のロボティクス向け新基盤モデル「S1」を発表した。
Skild AIは火曜日にXへ投稿で、S1は最大10分間続く長時間タスクを、コンテキスト内学習を使って実行すると説明した。同社によると、S1はさまざまな環境や異なるロボット形態で、これらの動作を実行できる。
実演されたスキルには、コーヒーを入れる、植物を鉢に植える、パンケーキを焼くといったものが含まれており、これらはモデルの事前学習データには含まれていなかった。
「S1が初めてパンケーキを裏返したとき、私たちはパンケーキを裏返す動作が事前学習データに含まれているに違いないと考えました」とSkild AIは述べた。「事前学習データ全体を検索したところ、裏返しの例は見つかりませんでした。S1は1本の動画プロンプトから、分布外のタスクを推論したのです」
同社によると、S1は従来の視覚・言語・行動(VLA)モデルと比べて「飛躍的な進歩」を遂げている。既知のタスクでは、言語で指示されたVLAと同等の性能を発揮できる一方、まったく新しいタスクの学習では、既存の言語指示型VLAを上回るという。
Skild AIは、既存のVLAモデルが同程度の1例学習精度に達するには、追加のデータ収集とファインチューニングに50~100時間を要すると見積もった。
チームはまた、新モデルが動画のデモンストレーションを盲目的に模倣するのではなく、与えられたプロンプトを超えた「常識的な」理解を示すと説明した。摂動に耐えたり、即興で対応したり、動画で示されたものよりも高い精度を発揮したりすることも可能だという。
S1は、Skild AIが昨年LocoFormerで発表した、移動に関するコンテキスト内学習機能を発展させたものだ。LocoFormerにより、ロボットは脚が動かなくなったり車輪がロックされたりするような障害に適応できるようになった。
Skild AIは、限られた産業パートナーへのS1の導入を開始しており、今後数カ月以内により広範な展開を計画していると述べた。