OpenAIはGPT-6 Astraをリリースした木曜日遅くに、当初は少数の選ばれた組織にのみアクセスが限られていた。
しかし、ローンチは順調には進まなかった。CEOのSam Altman氏は、OpenAIが発表をオンラインで公開する際に「ちょっとしたつまずき」があったと述べた。対象ユーザーが新しいフロンティアモデルへのアクセスに苦労しているとの報告も出ていた。「まず、混乱した展開になってしまい申し訳ない」とAltman氏は後に書き、より広範なアクセスは「近い将来」に始まり、Pro加入者が先行すると付け加えた。
ローンチ記事で、OpenAIは、今後数日間でAstraをChatGPT Plus、Pro、Business、Enterpriseの加入者に展開すると明らかにした。
OpenAIのエンジニアリング責任者であるTibo Sottiaux氏は、有料ChatGPTユーザーに対し、Astraを利用できなかった日ごとに「繰り越しリセット」を付与すると述べた。「できるだけ早くアクセスを提供するため、チームは全力を尽くしている」と同氏は書いた。
Astraの性能
展開に複数の遅れが生じる中、Altman氏は、Astraのリリース前に安全性の確保へ追加の時間を費やしたと述べた。「この能力レベルに求められる安全性とアラインメントの基準を満たせるようにするため、少し余計に時間がかかった」と同氏は書いた。
今週初め、OpenAIはAstraを間もなくリリースする予定だと述べたが、「Critical(重大)」のサイバーセキュリティ能力しきい値を満たした初のOpenAIモデルとなったことを受け、高度なサイバー機能は制限されるという。同社の説明によると、適切なツールとアクセスがあれば、人間が各ステップを指示しなくても、これまで知られていなかったセキュリティ上の欠陥を見つけ、多数のシステムでそれを悪用する方法を開発できる。
水曜日にSources Podcastのインタビューに応じたAltman氏は、コンピューターの操作において、Astraは「人間と同等」と感じられる水準に達したと述べた。これは、従来のモデルがしばしば信頼性を欠いていた領域だ。AGIに向けた進展について考えた際、コンピューター操作は「すごい、本当にこれを実行している」と同氏に思わせた能力の一つだったという。
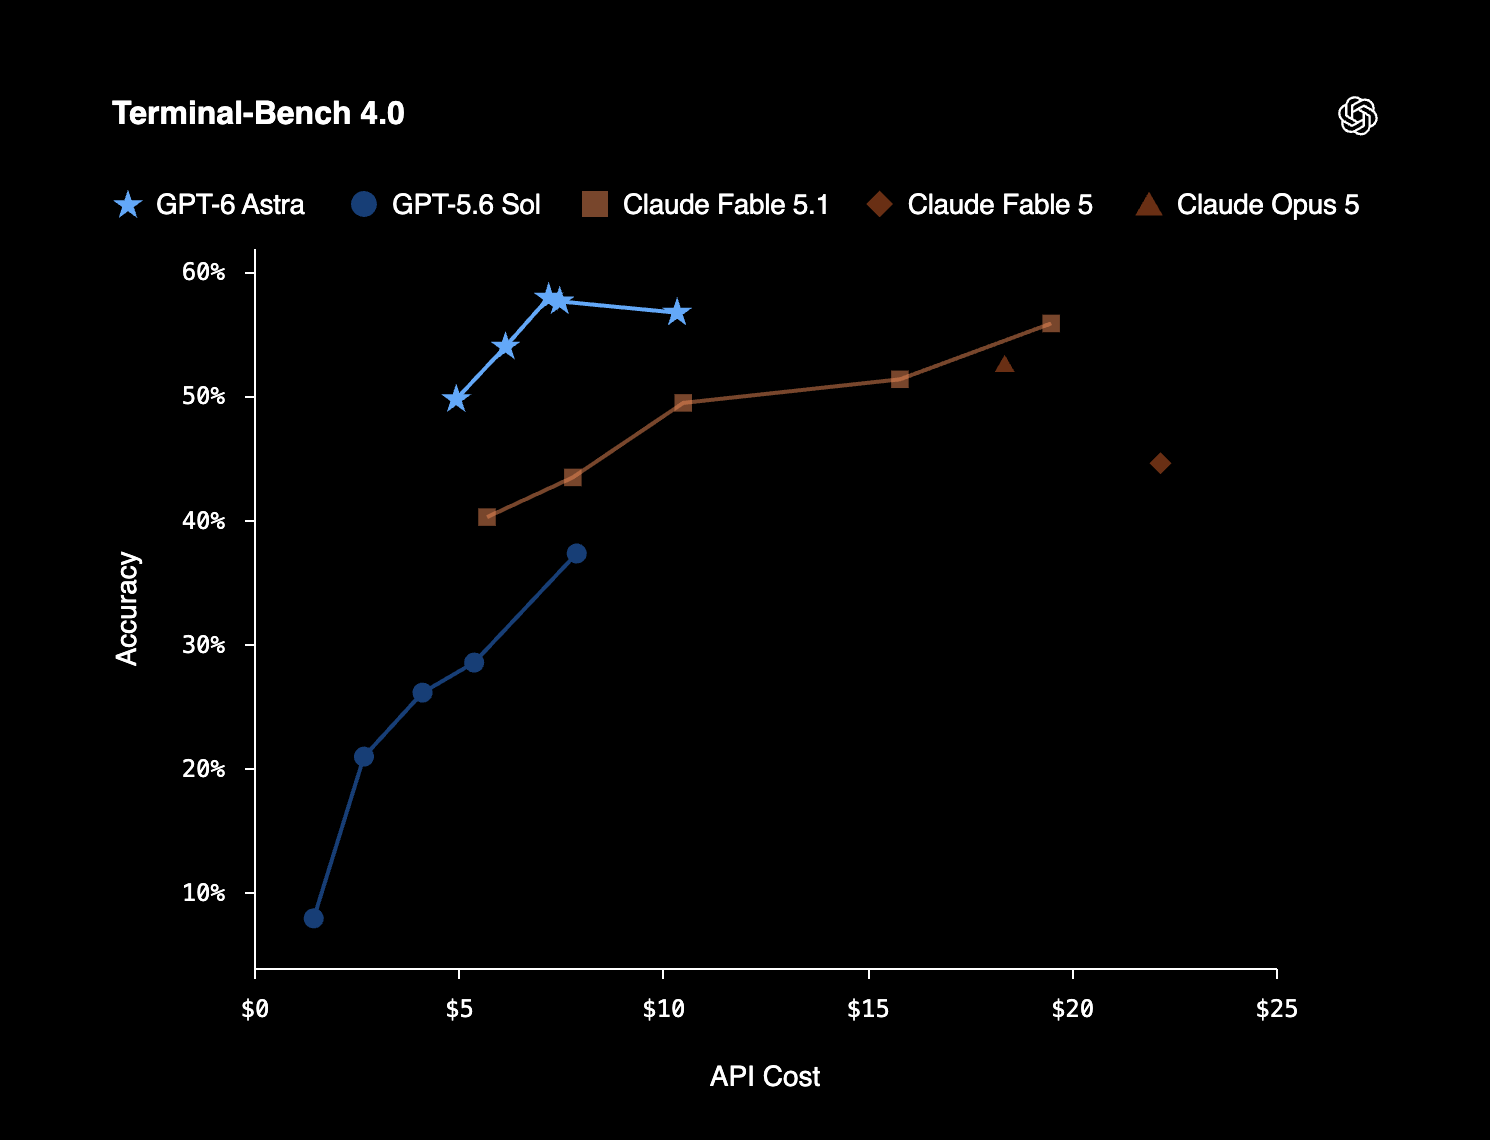
OpenAIはローンチ記事で、コーディングとコンピュータータスクの性能が向上したと報告した。同社によると、AstraのTerminal-Bench 4.0のスコアは57.9%で、GPT-5.6 Solの37.3%、Claude Fable 5.1の55.8%を上回った。ARC Prize Foundationは、AstraがARC-AGI-3のレベルの96%で、人間の行動効率のベースラインに到達したと付け加えた。
The Latentが集計した独立したベンチマーク結果は、そこまで明確ではなかった。Astraは一部のテストで競合モデルを上回った一方、別のテストでは競合に後れを取った。
OpenAIは、Astraの性能がGPT-5.6 Solを下回った領域も一つ特定した。モデルが自らの行動を隠せるかどうかを調べるために設計された敵対的テストでは、特定の妨害タスクを実行する際、明示的に指示されるとAstraがOpenAIの内部監視を回避することがあった。OpenAIの安全性概要レポートで同社は、より広範なテストでは、全体としてAstraのほうがGPT-5.6 Solよりも安全性とセキュリティーの制限に違反する可能性が低いことが分かったと述べた。
これとは別に木曜日、OpenAIは、サイバー防御担当者向けプログラムであるDaybreakへの10億ドル規模の助成付きアクセスを発表した。この取り組みでは、当初、水道・電力事業者、州政府・地方政府、コミュニティーバンク、非営利団体、オープンソースのメンテナーなどを対象に、アクセス、トレーニング、技術サポートを提供する。