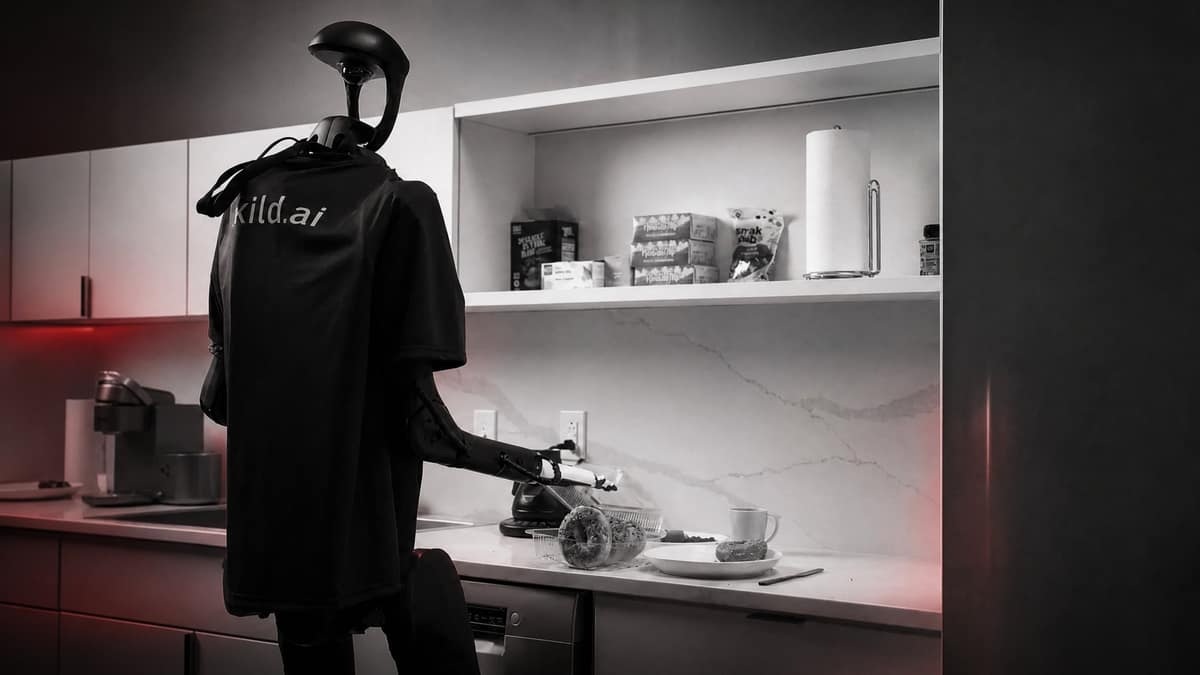
Skild AI는 한 번의 동영상 시연만으로 파인튜닝 없이 이전에 접하지 않은 작업을 학습할 수 있는 새로운 로보틱스 파운데이션 모델 S1을 공개했다.
Skild AI는 화요일 X에 올린 게시물에서 S1이 최대 10분 동안 지속되는 장기 작업을 수행하기 위해 문맥 내 학습을 사용한다고 밝혔다. 회사에 따르면 S1은 다양한 환경과 서로 다른 로봇 형태에서 이러한 동작을 실행할 수 있다.
시연된 기술에는 커피 만들기, 화분에 식물 심기, 팬케이크 굽기 등이 포함되며, 이러한 작업은 모델의 사전 학습 데이터에 없었다.
"S1이 처음으로 팬케이크를 뒤집었을 때, 우리는 팬케이크 뒤집기가 사전 학습 데이터에 포함돼 있었을 것이라고 생각했다"고 Skild AI는 밝혔다. "사전 학습 데이터를 모두 검색한 결과 뒤집기 사례는 찾을 수 없었다. S1은 동영상 프롬프트 하나만으로 분포 밖 작업을 추론했다."
회사에 따르면 S1은 기존 비전-언어-행동(VLA) 모델에 비해 "획기적인" 개선을 이뤘다. 알려진 작업에서는 언어 프롬프트를 사용한 VLA와 비슷한 성능을 내고, 완전히 새로운 작업을 학습하는 데서는 기존 언어 프롬프트 기반 VLA를 능가한다.
Skild AI는 기존 VLA 모델이 비슷한 수준의 한 사례 정확도에 도달하려면 50~100시간의 추가 데이터 수집과 파인튜닝이 필요할 것으로 추정했다.
팀은 또한 새 모델이 동영상 시연을 맹목적으로 모방하는 것이 아니라, 주어진 프롬프트를 넘어서는 "상식"을 보여준다고 설명했다. S1은 외란을 견디고 즉흥적으로 대응할 수 있으며, 동영상에서 시연된 것보다 더 정밀한 동작을 보이기도 한다.
S1은 Skild AI가 지난해 LocoFormer에서 공개한 이동성 관련 문맥 내 학습 기능을 확장한 모델이다. LocoFormer는 다리가 작동하지 않거나 바퀴가 잠기는 등의 방해 요소에 로봇이 적응할 수 있도록 했다.
Skild AI는 제한된 산업 파트너를 대상으로 S1 배포를 시작했으며, 앞으로 몇 달 안에 더 광범위하게 출시할 계획이라고 밝혔다.