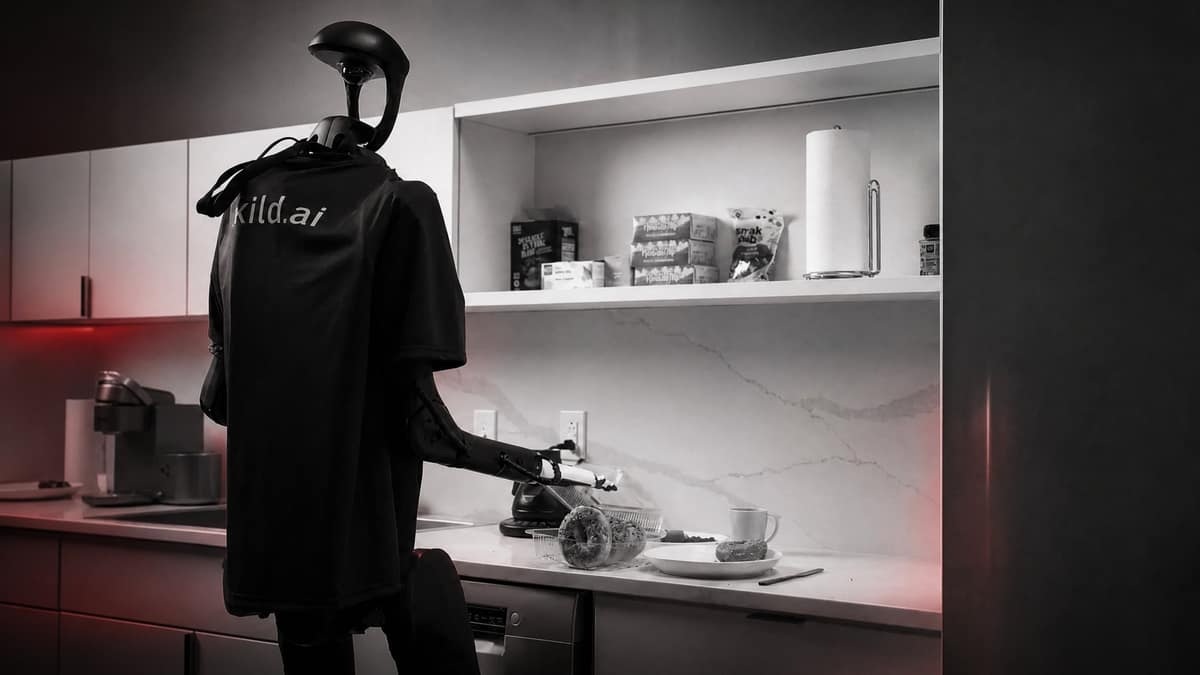
Skild AI 推出了 S1,这是该公司的新型机器人基础模型,无需微调即可从单段视频演示中学习此前未见过的任务。
Skild AI 在周二发布于 X 的帖子中表示,S1 利用上下文学习来执行最长可持续 10 分钟的长时程任务。该公司称,S1 能够在各种环境中、通过不同的机器人本体执行这些动作。
展示的技能包括煮咖啡、给植物换盆和煎松饼,而这些技能并未出现在模型的预训练数据中。
“S1 第一次翻松饼时,我们以为翻松饼一定出现在它的预训练数据中,”Skild AI 表示。“我们搜索了全部预训练数据,却没有找到任何翻松饼的示例。S1 仅凭一个视频提示,就推断出了这一分布外任务。”
该公司称,与传统的视觉-语言-动作(VLA)模型相比,S1 实现了“跨越式”改进——对于已知任务,它能达到语言提示式 VLA 的性能;而在学习全新任务方面,其表现优于现有的语言提示式 VLA。
Skild AI 估计,现有 VLA 模型需要额外收集 50 至 100 小时的数据并进行微调,才能达到相当的一次示例准确率。
团队还指出,他们的新模型不会盲目模仿视频演示,而是展现出超越给定提示的“常识”理解能力。它能够应对干扰、即兴发挥,甚至展现出比视频演示更高的精确度。
S1 延续并拓展了 Skild AI 去年在 LocoFormer 中公布的移动性上下文学习能力。LocoFormer 使机器人能够适应腿部失灵、车轮锁死等干扰情况。
Skild AI 表示,公司已开始向少数工业合作伙伴部署 S1,并计划在未来几个月内扩大部署范围。